9 zasad programowania z AI - #5: Zamień błędy w guardraile
Spis treści
W poprzedniej części agent musiał udowodnić, że skończył pracę. Ale jeśli co tydzień dowodzi tego samego, a my co tydzień poprawiamy ten sam błąd, to dowody niewiele zmieniają. Czas zająć się przyczyną.
Zasada #5: zamień powtarzające się błędy w guardraile
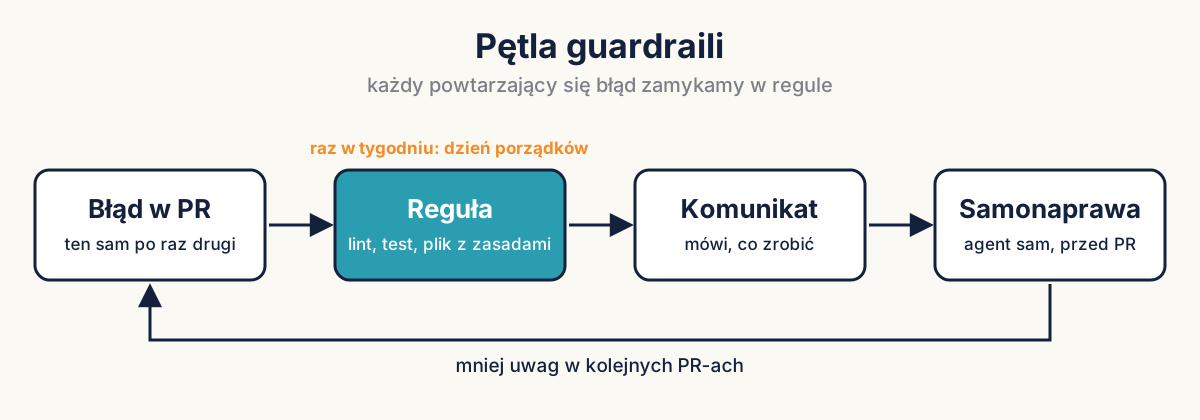
Gdy ten sam błąd wraca w kolejnych zadaniach, nie poprawiaj kodu, tylko środowisko. Automatyczny sprawdzacz kodu (tzw. lint), specjalny test, plik z zasadami albo drugi agent-recenzent przypomną agentowi o wymaganiu dokładnie wtedy, gdy trzeba, i zrobią to na stałe.
Guardrail to po polsku barierka: coś, co nie pozwala zjechać z drogi, zamiast prosić kierowcę, żeby uważał.
Dlaczego samo polecenie dla agenta nie wystarczy? Ryan Lopopolo z OpenAI mówi, że do jednej dobrej poprawki w kodzie potrzeba mniej więcej 500 drobnych decyzji w sprawach, których nie widać na pierwszy rzut oka: jak długo czekać na odpowiedź innego systemu, co robić przy błędzie, jak porządkować kod. Agent widział mnóstwo kodu z każdym możliwym wyborem, więc to my musimy zapisać, który jest dla nas akceptowalny. Nie zmieści się to w jednym poleceniu, a kontekst jest przecież ograniczony (o czym była mowa na początku serii).
Przykład: timeout i retry
Weźmy przykład znany każdemu, kogo kiedyś wezwano do awarii sieciowej. Gdy program pyta inny system o dane, a ten nie odpowiada, trzeba ustalić dwie rzeczy: ile czekać (tzw. timeout) i czy spróbować jeszcze raz (retry). Kto o tym zapomni, ryzykuje awarię, której jedno ponowienie by uniknęło. Lopopolo przyznaje, że sam nieraz dopisywał te zabezpieczenia w poprawce błędu i szedł dalej, bo jako autor i recenzent kodu nie jest w tym niezawodny.
Zamiast na pamięć, postawił na system: dokument oraz własny sprawdzacz kodu (lint), który pilnuje, żeby każde wywołanie sieciowe miało limit czasu i ponowienie. Problem rozwiązany raz na stałe, bo agent potrafi przerobić cały istniejący kod pod nową regułę.
Testy na kod źródłowy
Drugi rodzaj to testy, które sprawdzają nie to, co program robi, tylko jak jest zbudowany. W jego zespole takich testów jest kilka:
- plik nie może mieć więcej niż 350 linii (agentowi łatwiej go zmieścić w kontekście),
- porządek w tym, który fragment kodu może korzystać z którego,
- jedno wspólne narzędzie do danej czynności zamiast wielu kopii,
- brak zdublowanych opisów tych samych danych.
Powód? Agent czasem dba o porządek w jednym fragmencie kodu i pisze własne rozwiązanie, zamiast sięgnąć po wspólne narzędzie. Taki test to wychwytuje, a człowiek nie musi tracić uwagi na takie rzeczy podczas przeglądu zmian.
Komunikat błędu jest promptem
Sama blokada nie uczy. Różnicę widać na przykładzie: zamiast suchego „błąd w linii 12” komunikat powinien powiedzieć, czego nie wolno, dlaczego (dane sprawdzamy przy wejściu do programu, a nie w środku) i co zamiast tego zrobić (użyć gotowego opisu danych). To samo dotyczy złączy MCP, przez które agent korzysta z zewnętrznych narzędzi: według materiału o ich projektowaniu błąd powinien mówić, co poszło nie tak, dlaczego i co spróbować dalej. W przykładzie z Goose, gdy plik jest za duży (ponad 400 KB), komunikat tłumaczy limit i podpowiada, jak wczytać tylko jego fragment.
Jeszcze jedna rada z materiału o MCP: loguj najczęstsze błędy agenta, bo często wskazują błąd w opisie narzędzia, a nie w samym agencie.
Instrukcje wtedy, gdy są potrzebne
Nie trzeba też ładować wszystkich wymagań na starcie. Dobrze to widać na przykładzie interfejsu strony, który ma składać się z małych, niezależnych kawałków. Zamiast wciskać to w polecenie na początku, Lopopolo pozwala agentowi najpierw pobawić się interfejsem, a dopiero przy sprawdzeniu mówi: żeby to skończyć, rozbij ten fragment na mniejsze. Agent traktuje to jako nową instrukcję i poprawia swoją pracę. Takie podejście ma przy okazji tę zaletę, że nie zestarzeje się wraz z kolejnymi modelami.
Rytuał: dzień porządków
Reguły nie biorą się znikąd. Zespół Lopopolo ma w piątki dzień „sprzątania” (po angielsku „garbage collection”): każdy zbiera „śmieci”, które w tygodniu utrudniały włączanie zmian do głównej wersji kodu, i szuka sposobu, żeby wyeliminować całą klasę takich problemów. Uwaga z przeglądu zmian staje się dokumentem w repozytorium, a potem testem albo agentem-recenzentem.
Takich recenzentów mają kilku, każdy w innej roli (architekt interfejsu, inżynier niezawodności, ktoś od skalowalności). Uruchamiają się przy każdej wysłanej zmianie i zgłaszają problemy poważniejsze niż drobna uwaga, na podstawie dokumentów opisujących, jak wygląda dobra robota. Po dopisaniu kolejnych reguł „śmieci” w PR-ach zaczęło ubywać.
W zespole Claude Code działa podobnie: powtarzający się komentarz zamienia się w poprawkę u źródła, czyli w instrukcję dla agenta (skill), regułę sprawdzacza kodu albo plik z zasadami. Jednym z takich plików jest REVIEW.md (zasady przeglądu zmian), który piszą właściciele kodu: jak wygląda porażka w danym miejscu, ile drobnych uwag wolno zgłaszać, które fragmenty pomijać i że każde znalezisko wymaga dowodu (plik i linia).
Co z tym zrobić od jutra?
- Prowadź listę „co poprawiam drugi raz”, a raz w tygodniu zamień jedną pozycję w automatyczną regułę lub test
- Zacznij od jednej prostej reguły, np. maksymalnej długości pliku, i jednego komunikatu błędu z instrukcją naprawy
- Spisz zasady przeglądu zmian (np. w pliku
REVIEW.md): czego szukać, czego nie komentować, jak wygląda dowód - Błędy w swoich narzędziach pisz tak, żeby agent po nich wiedział, co zrobić
Jedna pułapka: guardrail bez komunikatu naprawczego tylko blokuje agenta. Reguła ma wskazywać drogę, a nie ją zamykać.
To praktyka jednego zespołu na dużą skalę, z bardzo dużym budżetem na tokeny. Zasada jest jednak niezależna od rozmiaru: błąd, który wraca raz po raz, zasługuje na regułę.
W następnej części zajmiemy się skillami: dlaczego lepiej mieć ich mało, małe i mierzone.
A Wy – jakiego błędu agenta poprawiacie najczęściej i co by go zamknęło: lint, test czy recenzent? Napiszcie w komentarzach 🙂
Komentarze
Ładowanie komentarzy…