9 zasad programowania z AI - #3: Zdefiniuj „gotowe”
Spis treści
W poprzedniej części ustalaliśmy, co właściwie budujemy. Teraz drugie pytanie, równie ważne: skąd będziemy wiedzieć, że to zostało zbudowane?
Agent kończy zadanie, testy świecą na zielono, wszystko wygląda dobrze. Tyle że zielone testy potwierdzają jedynie, że kod robi to, co robi. Pisałem już o takim scenariuszu we wpisie o końcu Eldorado: AI dopisuje testy, wszystko przechodzi, a po kilku dniach użytkownicy widzą dane innych kont. Problem nie leżał w tym, że testów brakowało, tylko w tym, że nikt wcześniej nie ustalił, co mają sprawdzać.
Zasada #3: zapisz, co znaczy „gotowe”, zanim powstanie kod
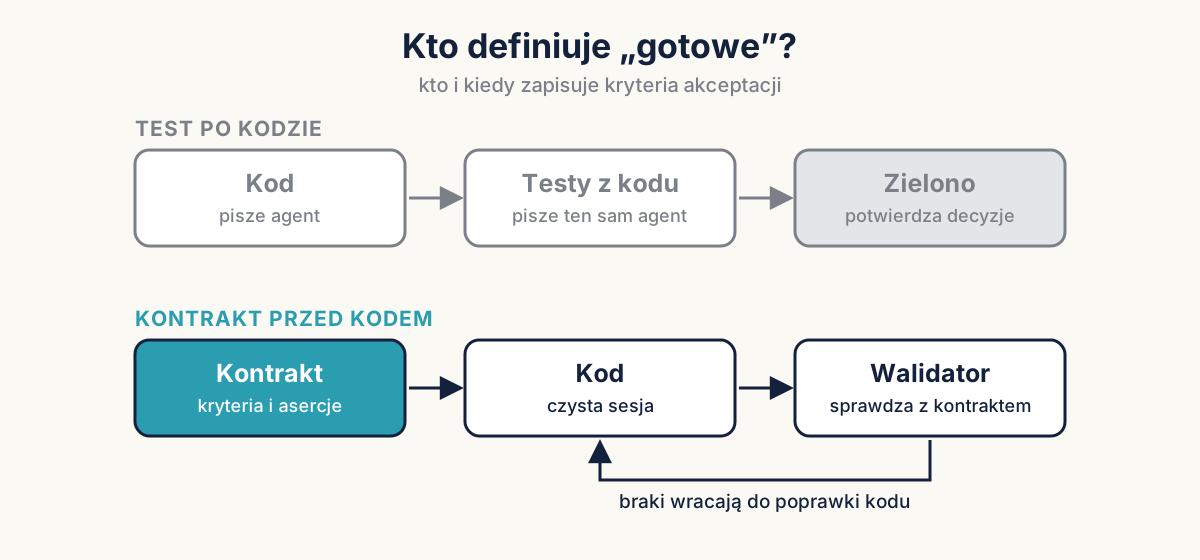
Jeśli „gotowe” definiuje ten sam agent, który właśnie napisał kod, jego testy potwierdzają jego decyzje, a nie łapią jego błędy. Tak ujął to Alvoeiro z Factory w wystąpieniu o pracy wielu agentów naraz: testy napisane po kodzie „potwierdzają decyzje, nie łapią błędów”, więc system powoli dryfuje.
Dlatego u nich kryteria akceptacji powstają przed implementacją, w osobnym dokumencie, niezależnym od tego, jak kod zostanie napisany.
Kontrakt walidacji
Jak to wygląda u Factory? Orchestrator (agent-planista) planuje funkcje i kamienie milowe, a razem z nimi tworzy kontrakt walidacji. Każda funkcja ma przypisane asercje (konkretne sprawdzenia), a wszystkie razem pokrywają całość. Dopiero wtedy worker (agent-wykonawca) implementuje funkcję w czystym kontekście, a osobny walidator (agent-kontroler) sprawdza wynik względem kontraktu.
Po każdym kamieniu milowym działają dwa walidatory. Pierwszy to automatyczne testy i kontrole kodu oraz osobny agent, który przegląda każdą funkcję (code review). Drugi uruchamia aplikację i działa jak tester, np. przez obsługę komputera jak człowiek (computer use). Żaden z nich nie brał udziału w pisaniu kodu, więc ich ocena jest niezależna od workera.
Alvoeiro podaje liczby z przykładu, w którym agenci zbudowali klon Slacka: ok. 60% czasu i tokenów poszło na implementację, ok. 50% linii kodu to testy, pokrycie wyniosło ok. 90%, a walidacja nigdy nie przeszła za pierwszym razem – zawsze były poprawki. To jedna misja jednego zespołu, więc potraktujmy te liczby jako ilustrację, nie normę.
Małe kroki
Drugi powód, żeby zacząć od testu: agent pisze za dużo naraz. Pocock mówi, że model „wyprzedza reflektory” – nim zobaczy, czy poprzedni krok działa, napisze kilka następnych. Prędkością w pracy z AI jest więc tempo informacji zwrotnej. TDD (tworzenie kodu od testu) wymusza taki rytm: najpierw test, potem kod, potem porządki w kodzie (refaktoryzacja), a dopiero następny krok.
Kryteria bywają szersze niż testy
Lopopolo z OpenAI opisuje plan QA (testowania jakości): dokument, w którym zespół spisuje funkcje aplikacji, krytyczne ścieżki użytkownika i to, jakie materiały mają trafić do propozycji zmiany (PR), żeby uznać zmianę za udowodnioną. Dzięki temu agent-recenzent ma co weryfikować, a człowiek rzadziej musi zaglądać agentowi przez ramię.
Podobnie w kursie o pracy z agentami (DeepLearning.AI i JetBrains): specyfikacja funkcji z planem, wymaganiami i sposobem weryfikacji trafia do historii zmian (commit) jeszcze przed implementacją. A gdy w kodzie wyjdzie błąd, bywa on błędem w planie – wtedy poprawia się oba.
Co z tym zrobić od jutra?
- Do każdego zadania dopisz kryteria akceptacji, zanim agent ruszy. Wystarczą 2–3 zdania opisujące efekt, a jeśli nie umiesz ich napisać, zadanie nie jest jeszcze gotowe do delegowania
- Poproś agenta o listę przypadków brzegowych (nietypowych sytuacji) do skomentowania, zanim napisze kod
- Testy lub scenariusze najpierw, w osobnym zapisie zmian, a implementacja w kolejnej sesji
- Przy zmianach w interfejsie dopisz do kryteriów zrzut lub nagranie przed i po
- Małe kroki: jedna funkcja, jeden cykl, jeden commit
Jedna pułapka: testy pisane przez agenta „po fakcie” z gotowego kodu są zrzutem jego myślenia. Ten sam błąd siedzi i w kodzie, i w teście, więc zielony wynik dowodzi niewiele.
W następnej części zajmiemy się dowodami: skąd wiemy, że agent faktycznie uruchomił testy, a nie tylko napisał, że to zrobił.
A Wy – kto u Was pisze testy do kodu agenta: agent po fakcie, czy ktoś przed kodem? Dajcie znać w komentarzach 🙂
Komentarze
Ładowanie komentarzy…