9 zasad programowania z AI - #2: Ustalcie, o co chodzi
Spis treści
W poprzedniej części pisałem o kontekście: agent robi to, co wynika z tego, co ma w oknie. Teraz krok wcześniej – skąd ten kontekst się bierze i czy w ogóle opisuje to, co chcemy zbudować.
Każdy, kto trochę popracował z agentem, zna to rozczarowanie: prosimy o funkcję, dostajemy działający, zgrabny kod, tylko że zupełnie nie ten, o który chodziło. Zanim zaczniemy szukać winy w modelu, zapytajmy, czy agent w ogóle wiedział, czego od niego chcemy.
Zasada #2: najpierw ustalcie, o co chodzi
Najdroższy błąd w pracy z agentem to nie zły kod, tylko nietrafione zrozumienie zadania. Zły kod da się poprawić. Ale jeśli agent zrozumiał zadanie inaczej niż my, napisze to, co zrozumiał – szybko i na dużą skalę.
Matt Pocock w wystąpieniu Software Fundamentals Matter More Than Ever wskazuje przyczynę: brakuje wspólnego „konceptu projektu” (design concept – termin z książki Brooksa The Design of Design). Nasza wersja jest w naszej głowie, a nie w głowie agenta. Dex Horthy z HumanLayer dorzuca rachunek: zły fragment planu to setki złych linii kodu, a błąd w researchu (czyli w rozpoznaniu, jak działa system) psuje wszystko, co powstaje potem.
Niech agent wypyta Ciebie
Pocock proponuje odwrócić zwykły układ. Zamiast pisać długi opis zadania, prosimy agenta, żeby to on zadawał pytania, aż osiągniemy wspólne rozumienie. Jego instrukcja dla agenta (tzw. skill) nazywa się Grill Me i według autora pytań potrafi być nawet 40–100. Dopiero wynik takiej rozmowy zamieniamy w opis wymagań (PRD) albo listę zadań.
Prawdopodobnie działa to dlatego, że przy pisaniu opisu z góry widzimy tylko to, o czym pamiętamy. Wywiad wyciąga braki, o których nam nie przyszło do głowy wspomnieć – a agent, który ich nie znał, wypełniłby je po swojemu.
Słownik pojęć
Drugie narzędzie od Pococka jest zupełnie proste: zwykły plik tekstowy z tabelą terminów (ubiquitous language, czyli wspólny język zespołu z metody DDD). Każde pojęcie z domeny ma jedno znaczenie i jedną nazwę, a plik jest używany i w planowaniu, i w kodzie. Według autora poprawia to planowanie i skraca „myślenie” modelu, a do tego ogranicza rozwlekłość agenta.
Brzmi nieefektownie, ale odpowiada na konkretny kłopot: gdy w jednej rozmowie „klient”, „użytkownik” i „konto” znaczą co innego, agent zgaduje, o które chodzi.
Research, plan, implementacja
Horthy dzieli pracę na 3 kroki:
- research – obiektywne zrozumienie, jak system działa dziś,
- plan – kroki z nazwami plików, fragmentami kodu i testami po każdej zmianie,
- implementacja – już przy małym kontekście, o którym była mowa w poprzedniej części.
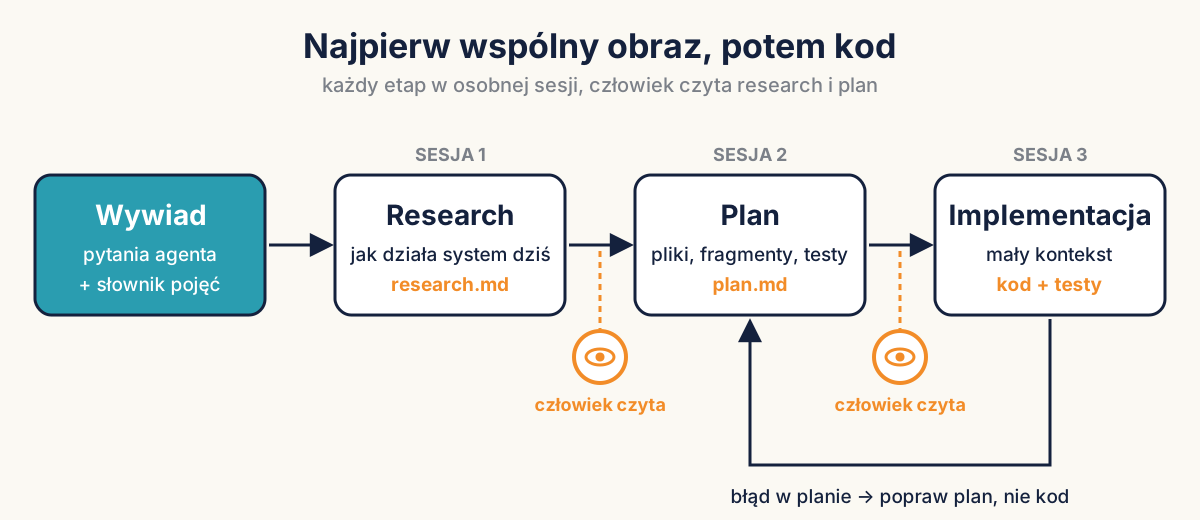
Wynik researchu i planu ląduje w pliku, więc kolejny krok startuje z niego, nie z historii rozmowy. Nazwy plików i podział na sesje na schemacie to przykład, nie dosłowny opis metody. Jako przykłady skuteczności Horthy podaje poprawkę w bazie kodu w języku Rust (projekt BAML) liczącej 300 tys. linii, którą zaakceptował CTO, czyli szef techniczny firmy, oraz ok. 35 tys. linii w 7 godzin (część to kod generowany). To relacje autora, nie pomiary, ale pokazują, do czego ta metoda służy: do pracy w dużych, starych bazach kodu.
Plan trzeba przeczytać
Cały ten porządek traci sens, jeśli nikt nie czyta researchu i planu. Hasło Horthy’ego brzmi: nie outsourcuj myślenia. Czytanie planów (a nie tysięcy linii kodu) jest też dobrym sposobem na to, żeby zespół rozumiał zmiany. Jest tu pewien kompromis: plan dłuższy jest bardziej niezawodny, ale mniej czytelny, więc zespół musi znaleźć swój złoty środek.
Ryan Lopopolo z OpenAI idzie dalej. Plan zatwierdzony bez czytania koduje instrukcje, których wcale nie chcemy. Dlatego plany wrzucajmy jako osobną propozycję zmian (PR) z samym planem i obowiązkowym przeglądem przez człowieka, zanim ruszy implementacja. W przeciwnym razie ryzykujemy, że czas pójdzie na realizację złych poleceń.
Nie każde zadanie potrzebuje tego wszystkiego
Skala procesu zależy od zadania. Dla dodania przycisku pełna ścieżka od researchu do implementacji to przesada, dla dużej funkcji już nie. Metoda ma też granice: Horthy opowiada o próbie usunięcia jednej dużej biblioteki (Hadoop) z projektu Parquet Java, przy której po wyrzuceniu planów zespół wrócił do tablicy.
Sam Lopopolo stoi jednak na drugim biegunie – w ogóle nie używa trybu planowania, bo oczekuje, że samo zgłoszenie zadania (ticket) wystarczy, żeby agent wykonał zadanie. Ale za jego agentem stoi cała infrastruktura sprawdzająca wynik. O niej będzie w kolejnych częściach.
A co z SDD?
Ta metoda przypomina Spec Driven Development (tworzenie oprogramowania od specyfikacji) – i słusznie, bo w obu chodzi o to samo: najpierw ustalić, potem pisać. Samo pojęcie jest jednak „semantycznie rozmyte”, jak zauważa Horthy, i znaczy około 100 różnych rzeczy. Liczy się kontrola kontekstu i wspólne rozumienie zadania, nie etykieta. Pocock jest jeszcze ostrzejszy: samo przerabianie specyfikacji na kod, bez dbania o jego jakość, daje coraz gorsze wyniki. Jeśli ktoś chce zobaczyć SDD jako konkretną metodę, pisałem o niej w osobnym wpisie.
Co z tym zrobić od jutra?
- Przed większym zadaniem napisz agentowi: „Wypytaj mnie, aż będziesz wiedział, co budujemy”. Odpowiedzi zapisz do pliku
- Załóż słownik pojęć z kilkunastoma terminami domeny i wskaż go w
CLAUDE.md(pliku z zasadami dla agenta) - Podziel pracę na 3 sesje: research, plan, implementacja – wynik każdej do pliku
- Przeczytaj plan, zanim ruszy implementacja. Jeśli nie zamierzasz go czytać, lepiej nie wprowadzać planów w ogóle
- Zadania na jeden plik rób bez ceremonii
Jedna pułapka: zatwierdzenie planu, bo „wygląda dobrze”. Plan jest wtedy zwykłą formalnością, a agent i tak zrobi swoje.
W następnej części zajmiemy się zapisaniem, co znaczy „gotowe”, zanim agent napisze pierwszą linijkę – i tym, dlaczego testy napisane po kodzie częściej potwierdzają decyzje agenta, niż łapią jego błędy.
A Wy – agent wypytuje Was przed zadaniem, czy raczej opisujecie wszystko z góry? Jestem ciekaw, co u Was sprawdza się lepiej – napiszcie w komentarzach 🙂
Komentarze
Ładowanie komentarzy…