9 zasad programowania z AI - #1: Zarządzaj kontekstem
Spis treści
Ostatnio o AI w programowaniu pisałem już sporo – o programiście w czasach AI, o vibe coderach, o końcu Eldorado i o tym, co naprawdę mierzą badania. Tylko że to wszystko było raczej o tym, co się dzieje, a czytelnik – i ja sam – po takim tekście zwykle zadaje jedno proste pytanie: no dobrze, ale co mam zrobić w poniedziałek rano, jak otworzę terminal?
Dlatego zaczynam serię: 9 krótkich wpisów, w każdym jedna zasada pracy z agentami kodującymi (programami AI, które same piszą i poprawiają kod), zebrana z wystąpień i artykułów ludzi z OpenAI, Anthropic, WorkOS, Factory, HumanLayer i kilku innych miejsc. To głównie relacje z praktyki, nie badania, a przy liczbach napiszę, skąd pochodzą 🙂
Zasada #1: zarządzaj kontekstem, nie długością promptu
O tym, co zrobi agent w następnym kroku, decyduje wyłącznie to, co ma teraz w kontekście, czyli to wszystko, co ma w danej chwili „przed oczami”: dotychczasowa rozmowa, polecenia i wczytane pliki. Model nie „pamięta”, co mówiliśmy wczoraj, ani nie „wie”, co mieliśmy na myśli. Czyta rozmowę od początku i na tej podstawie dopisuje dalszy ciąg.
Dex Horthy z HumanLayer w wystąpieniu No Vibes Allowed ujął to tak, że kontekst jest jedyną dźwignią, jaką mamy. I wskazał 4 rzeczy, które można w nim optymalizować: poprawność (czy to, co jest w oknie, jest prawdą), kompletność (czy niczego nie brakuje), rozmiar (ile tego jest) i trajektorię (dokąd ta rozmowa dotąd zmierzała). Z jego obserwacji wynika taka hierarchia: gorzej szkodzi błędna informacja niż jej brak, a brak informacji bardziej niż zwykły szum.
Spójrzmy na to przez pryzmat poleceń dla agenta, czyli tzw. promptów. Wielu z nas intuicyjnie myśli: im dłuższe i bardziej szczegółowe polecenie, tym lepiej. A tu się okazuje, że ważniejsze jest to, żeby w całym oknie nie było rzeczy nieprawdziwych albo zbędnych. Długie polecenie z jednym przestarzałym zdaniem może być gorsze niż krótkie, ale prawdziwe.
Strefa głupoty
Teraz rozmiar. Okno kontekstu ma swój limit (w Claude Code to mniej więcej 168 tys. tokenów, czyli kawałków tekstu, na które model dzieli wszystko, co czyta), ale problemy zaczynają się dużo wcześniej. Horthy mówi o „dumb zone” – strefie, w której jakość decyzji agenta zaczyna wyraźnie spadać już około 40% okna, w zależności od zadania. To szacunek z doświadczenia prelegenta, a nie wynik pomiaru.
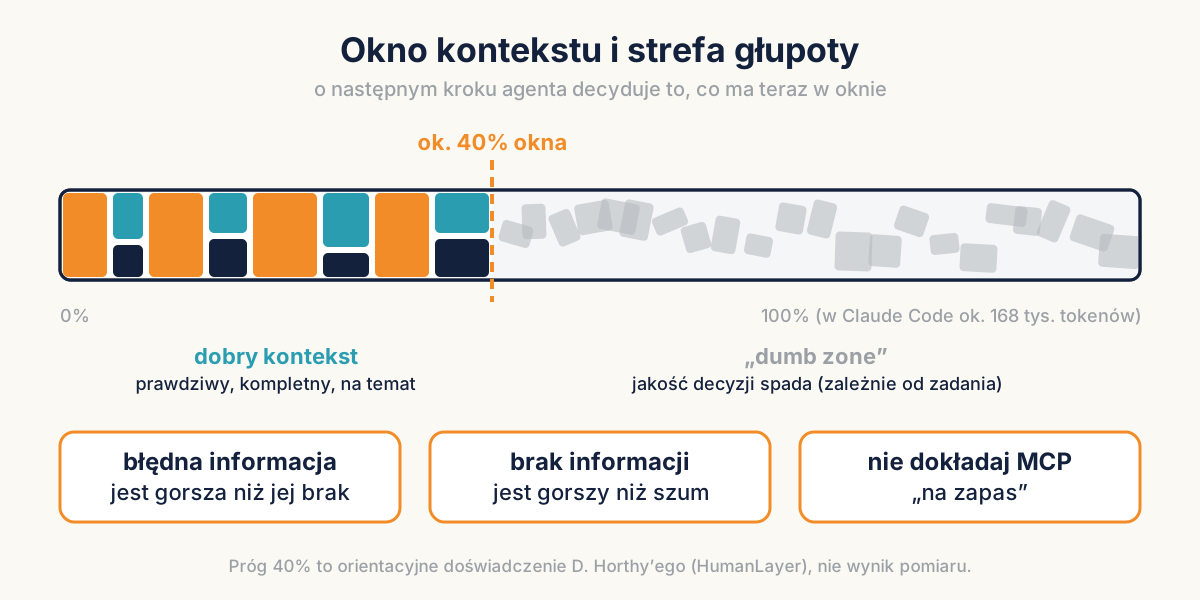
Co z tego wynika w praktyce? Na przykład to, że zbyt wiele serwerów MCP (złączy, przez które agent korzysta z zewnętrznych narzędzi) to praca w strefie głupoty – każdy z nich dokłada opisy narzędzi, które agent czyta w każdej turze, zanim w ogóle zacznie robić swoje. Wyłączenie tych, które nie są potrzebne w tym zadaniu, to najtańsza optymalizacja.
Podobnie jest z plikami w repozytorium (czyli w folderze z całym kodem projektu), bo kod w systemie plików to też kontekst. Ryan Lopopolo z OpenAI, który od 9 miesięcy buduje oprogramowanie wyłącznie przez agentów, opowiadał o teście pilnującym, żeby żaden plik nie miał więcej niż 350 linii. Nie z estetyki, tylko dlatego, że agent czytający mniejsze pliki oszczędza okno. To dobry przykład myślenia o repozytorium jak o czymś, co ma się „zmieścić w głowie” agenta.
I jeszcze jedno: dokumentacja w repo. Horthy zwraca uwagę, że dokumentacja się starzeje – w jego wykresie oś Y to „liczba kłamstw”. Dlatego proponuje, żeby część wiedzy o systemie generować na żądanie, z aktualnego kodu, zamiast ufać plikom, które ktoś kiedyś napisał i zapomniał zaktualizować. To ta sama zasada: błędna informacja szkodzi bardziej niż jej brak.
Poprawianie w kółko nie działa
Teraz trajektoria, i to najciekawsza obserwacja. Gdy agent robi coś źle, a my poprawiamy, poprawiamy i poprawiamy – rozmowa uczy go, że kolejnym krokiem w tej historii jest… błąd. Po prostu dopisuje dalszy ciąg do tekstu, w którym on się myli, a człowiek go za to strofuje.
Horthy radzi więc wprost: zamiast drążyć, zacznij od nowa. I to wcale nie musi oznaczać startu z zerowym kontekstem. Jego technika nazywa się intentional compaction – świadoma kompakcja:
- poproś agenta o podsumowanie do zwykłego pliku tekstowego – z dokładnymi ścieżkami plików i numerami linii, a nie „mniej więcej tu”,
- przeczytaj ten plik i popraw, co trzeba (to ważne, bo błąd w podsumowaniu przeniesie się na całą kolejną sesję),
- wyczyść sesję i wczytaj tylko to podsumowanie.
Dzięki temu nowa sesja startuje z małym, prawdziwym kontekstem i bez ogona nieudanych prób.
Jest też druga strona: automatyczna kompakcja. Lopopolo przyznaje, że przy nowszych modelach prawie nie musi już zaczynać nowych sesji – model sam kompresuje historię. Ale wniosek wyciąga dokładnie odwrotny niż „nie muszę się tym przejmować”: trzeba budować na założeniu, że kontekst będzie wypychany, i odświeżać go w trakcie pracy (jak – o tym w kolejnych częściach).
Co z tym zrobić od jutra?
Bez rewolucji, kilka drobnych nawyków:
/clearzamiast trzeciej poprawki (to komenda, która czyści rozmowę) – po drugiej nieudanej próbie nie pisz kolejnej, tylko zapisz stan do pliku (ścieżki, numery linii, decyzje, które zapadły i dlaczego) i zacznij czysto- subagenci do szukania (pomocnicze agenty) – szukają w osobnym oknie, a do głównej sesji wraca krótka odpowiedź. Horthy zaznacza, że subagenci służą do kontroli kontekstu, nie do odgrywania ról – podział na „frontendowca”, „backendowca” i „QA” uważa za antywzorzec
- odchudź narzędzia – wyłącz MCP, których nie używasz w tym zadaniu, trzymaj
CLAUDE.md(plik z podstawowymi zasadami dla agenta) krótki, a resztę wiedzy w skillach, czyli osobnych instrukcjach, które agent ładuje dopiero wtedy, gdy ich potrzebuje (o skillach jeszcze napiszę) - duże zadania dziel na etapy – każdy z osobną sesją (o tym w następnej części)
Jedna pułapka na koniec: „więcej kontekstu znaczy lepiej”. Nie znaczy. Wrzucanie do okna całych dokumentów „na wszelki wypadek” obniża jakość, bo szum zjada okno i przybliża nas do strefy głupoty. To tak jak z rozmową z kolegą w pracy – jak wyłożysz mu pół projektu zamiast jednego konkretnego problemu, to też straci wątek 🙂
Czy to rzeczywiście działa?
Skala efektu zależy od zadania: to relacje praktyków, a Horthy sam przyznaje, że progi są orientacyjne. Nie ma tu badania z grupą kontrolną. Ale to samo, tylko innymi słowami, powtarza się u dwóch autorów (Horthy, Lopopolo), więc uznałem, że to dobry fundament całej serii. Cała reszta opiera się na tym, żeby w oknie było mało, prawdziwie i na temat.
W następnej części zajmiemy się tym, co jest przed kodem: dlaczego warto wypytać agenta (albo dać się wypytać), zanim padnie pierwsza linijka. Spoiler: najdroższy błąd to nie zły kod, tylko nietrafione zrozumienie zadania.
A Wy – czy zdarzyło Wam się „przegadać” agenta do punktu, w którym tylko pogarszał sprawę? Jak sobie z tym radzicie: czyścicie sesję, czy poprawiacie do skutku? Dajcie znać w komentarzach – chętnie poczytam, jak to wygląda u Was 🙂
Komentarze
Ładowanie komentarzy…