9 zasad programowania z AI - #7: Dopasuj effort i liczbę agentów
Spis treści
W poprzedniej części przekonywałem, że więcej instrukcji nie znaczy lepiej. Z mocą agenta i z liczbą agentów jest podobnie: najwyższy poziom i największa armia nie zawsze dają najlepszy wynik, a zawsze kosztują.
Zasada #7: dopasuj moc i liczbę agentów do zadania
Poziom starania agenta ustawiaj pod zadanie, a równolegle zlecaj tylko czytanie, nie pisanie.
Co to jest effort
Narzędzia takie jak Claude Code pozwalają ustawić tzw. effort, czyli poziom starania agenta. Według artykułu Anthropic chodzi w przybliżeniu o to, ile mocy obliczeniowej (czyli jak długo i jak intensywnie model „myśli”) może wydać na zadanie. Agent i tak zawsze próbuje je skończyć. Wyższy poziom oznacza więcej samodzielnych działań przy sprawdzaniu własnej pracy i przy szukaniu nietypowych przypadków. Poziom można zmieniać w trakcie rozmowy, komendą /effort.
Najwięcej daje tam, gdzie jest dużo ukrytych niespodzianek: przy sprzęcie, bezpieczeństwie i przeglądzie kodu. Za to nie naprawi błędnego ogólnego podejścia: jeśli agent idzie w złą stronę, więcej starania poprowadzi go tylko dalej w złą stronę.
Co pokazują dane
Anthropic podaje wyniki z własnych testów, po 370 prób na każdy poziom. Przy najniższym poziomie zadania udało się w 140 próbach, przy najwyższym w 214. Błędów typu „agent pominął przypadek” było odpowiednio 59 i 24. W bezpieczeństwie skuteczność wzrosła z 64% do 87%, w zadaniach sprzętowych z 34% do 75%. Cena: typowe (środkowe) zużycie mocy skoczyło z 73 tys. do 222 tys. jednostek (tokenów), czyli ok. 3 razy.
Jedno zadanie z artykułu pokazuje to konkretnie. Przy niskim poziomie agent skończył po ok. 2 minutach i zdał test w 1 próbie na 5. Przy poziomie bardzo wysokim (tuż pod najwyższym) pracował ok. 33 minuty, przejrzał kod pod kątem ataków, przeczytał źródła używanej biblioteki i napisał zestaw testów bezpieczeństwa, a zadanie udało się w 5 próbach na 5. To wyniki z wewnętrznych uruchomień Anthropic, więc traktujmy je jako ilustrację.
Niejasne zadanie i wysoki poziom to zła mieszanka
Ten sam artykuł ostrzega: gdy zadanie jest niedoprecyzowane, wyższy poziom starania robi więcej założeń za nas. W uproszczonych przykładach czas pracy rósł od 1,5 minuty przy niskim poziomie do 67 minut przy najwyższym. Gdy zadanie było dobrze opisane, poziomy zachowywały się podobnie. Wniosek wraca do części #2: najpierw ustalcie, o co chodzi, a dopiero potem podnoście moc.
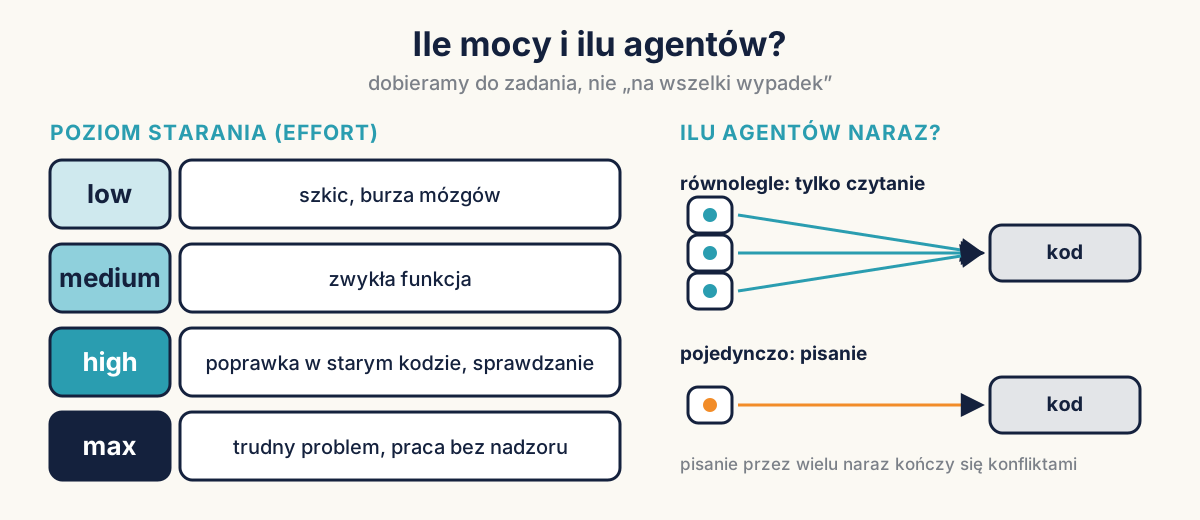
Anthropic proponuje prostą regułę doboru. Niski poziom na szkice i burzę mózgów, średni na zwykłą pracę, jak nowa funkcja, wysoki na sprawdzanie i nietypowe przypadki, np. poprawkę w starym kodzie, najwyższy na trudne problemy, które agent ma rozwiązać sam. Przy nowej funkcji: spisać wymagania i dać się wypytać, zaimplementować i przejrzeć na niskim poziomie, a sprawdzenie i testy zrobić na wysokim.
Ilu agentów naraz?
Inżynierowie coraz częściej prowadzą kilku agentów równolegle. Gergely Orosz opisuje, że inżynierowie prowadzą nawet 5–10 agentów równolegle. Ale Alvoeiro z Factory pokazuje inne podejście: w jego systemie w danej chwili pracuje jeden agent: albo pisze, albo sprawdza. Równolegle mogą działać tylko zadania, które nic nie zmieniają: szukanie w kodzie, research, przegląd. Pełna równoległość kończy się konfliktami, dublowaniem pracy i niespójnymi decyzjami.
Lopopolo z OpenAI przy 3–5 propozycjach zmian dziennie na osobę przekonał się, że konflikty przy łączeniu zmian bywają bardzo uciążliwe. Skrócił więc czas życia takich propozycji i podzielił kod na mniejsze, niezależne kawałki.
Różni agenci, różne modele
Alvoeiro dodaje jeszcze jedno: do różnych ról pasują różne modele. Planowanie lubi powolne, staranne rozumowanie, pisanie kodu szybką biegłość, a sprawdzanie precyzyjne wykonywanie instrukcji. Walidację dobrze powierzyć modelowi innego dostawcy, żeby nie miał tych samych uprzedzeń co ten, który kod napisał. Dobra struktura (kontrakt, kontrole po etapach) częściowo nadrabia słabszy model.
Mocy nie da się też rozpatrywać bez kosztów. Orosz zauważa, że w maju firmy martwiły się rachunkami za AI, a do września wiele z nich zmniejszyło koszt przetwarzania o ok. 50% (tańsze modele, kierowanie każdego zadania do odpowiedniego modelu). Dobór poziomu i modelu to więc także decyzja budżetowa.
Co z tym zrobić od jutra?
- Domyślnie średni poziom, szkice i poprawki na niskim, przegląd i poprawki w starym kodzie na wysokim
- Najpierw doprecyzuj zadanie, a dopiero potem podnoś poziom. Jeśli czas rośnie na niskim, dopracuj opis, zamiast kręcić gałką
- Równolegle zlecaj szukanie i research, a zmiany w jednym miejscu robi jeden agent
- Kontrolę zlecaj innemu modelowi niż pisanie, jeśli masz taką możliwość
Jedna pułapka: „najwyższy poziom, bo to ważne”. Przy niejasnym zadaniu to więcej założeń, nie więcej trafności.
W następnej części zajmiemy się przeglądem zmian: jak go dobrać do ryzyka, żeby człowiek czytał to, co ma znaczenie, a resztę zostawił maszynom.
A Wy – ilu agentów prowadzicie naraz i czy zdarzyło się Wam, że więcej oznaczało gorzej? Jestem ciekaw, na jakim poziomie pracujecie na co dzień – napiszcie w komentarzach 🙂
Komentarze
Ładowanie komentarzy…